Whitepapers e informes
Reposición automática: qué tiene que cumplirse antes de que funcione
Cuatro cosas que se deciden antes de la puesta en marcha determinan si la reposición automática funciona. Una lista de comprobación de nuestros proyectos, incluido cuándo no automatizar.
10. november 2026
13 min
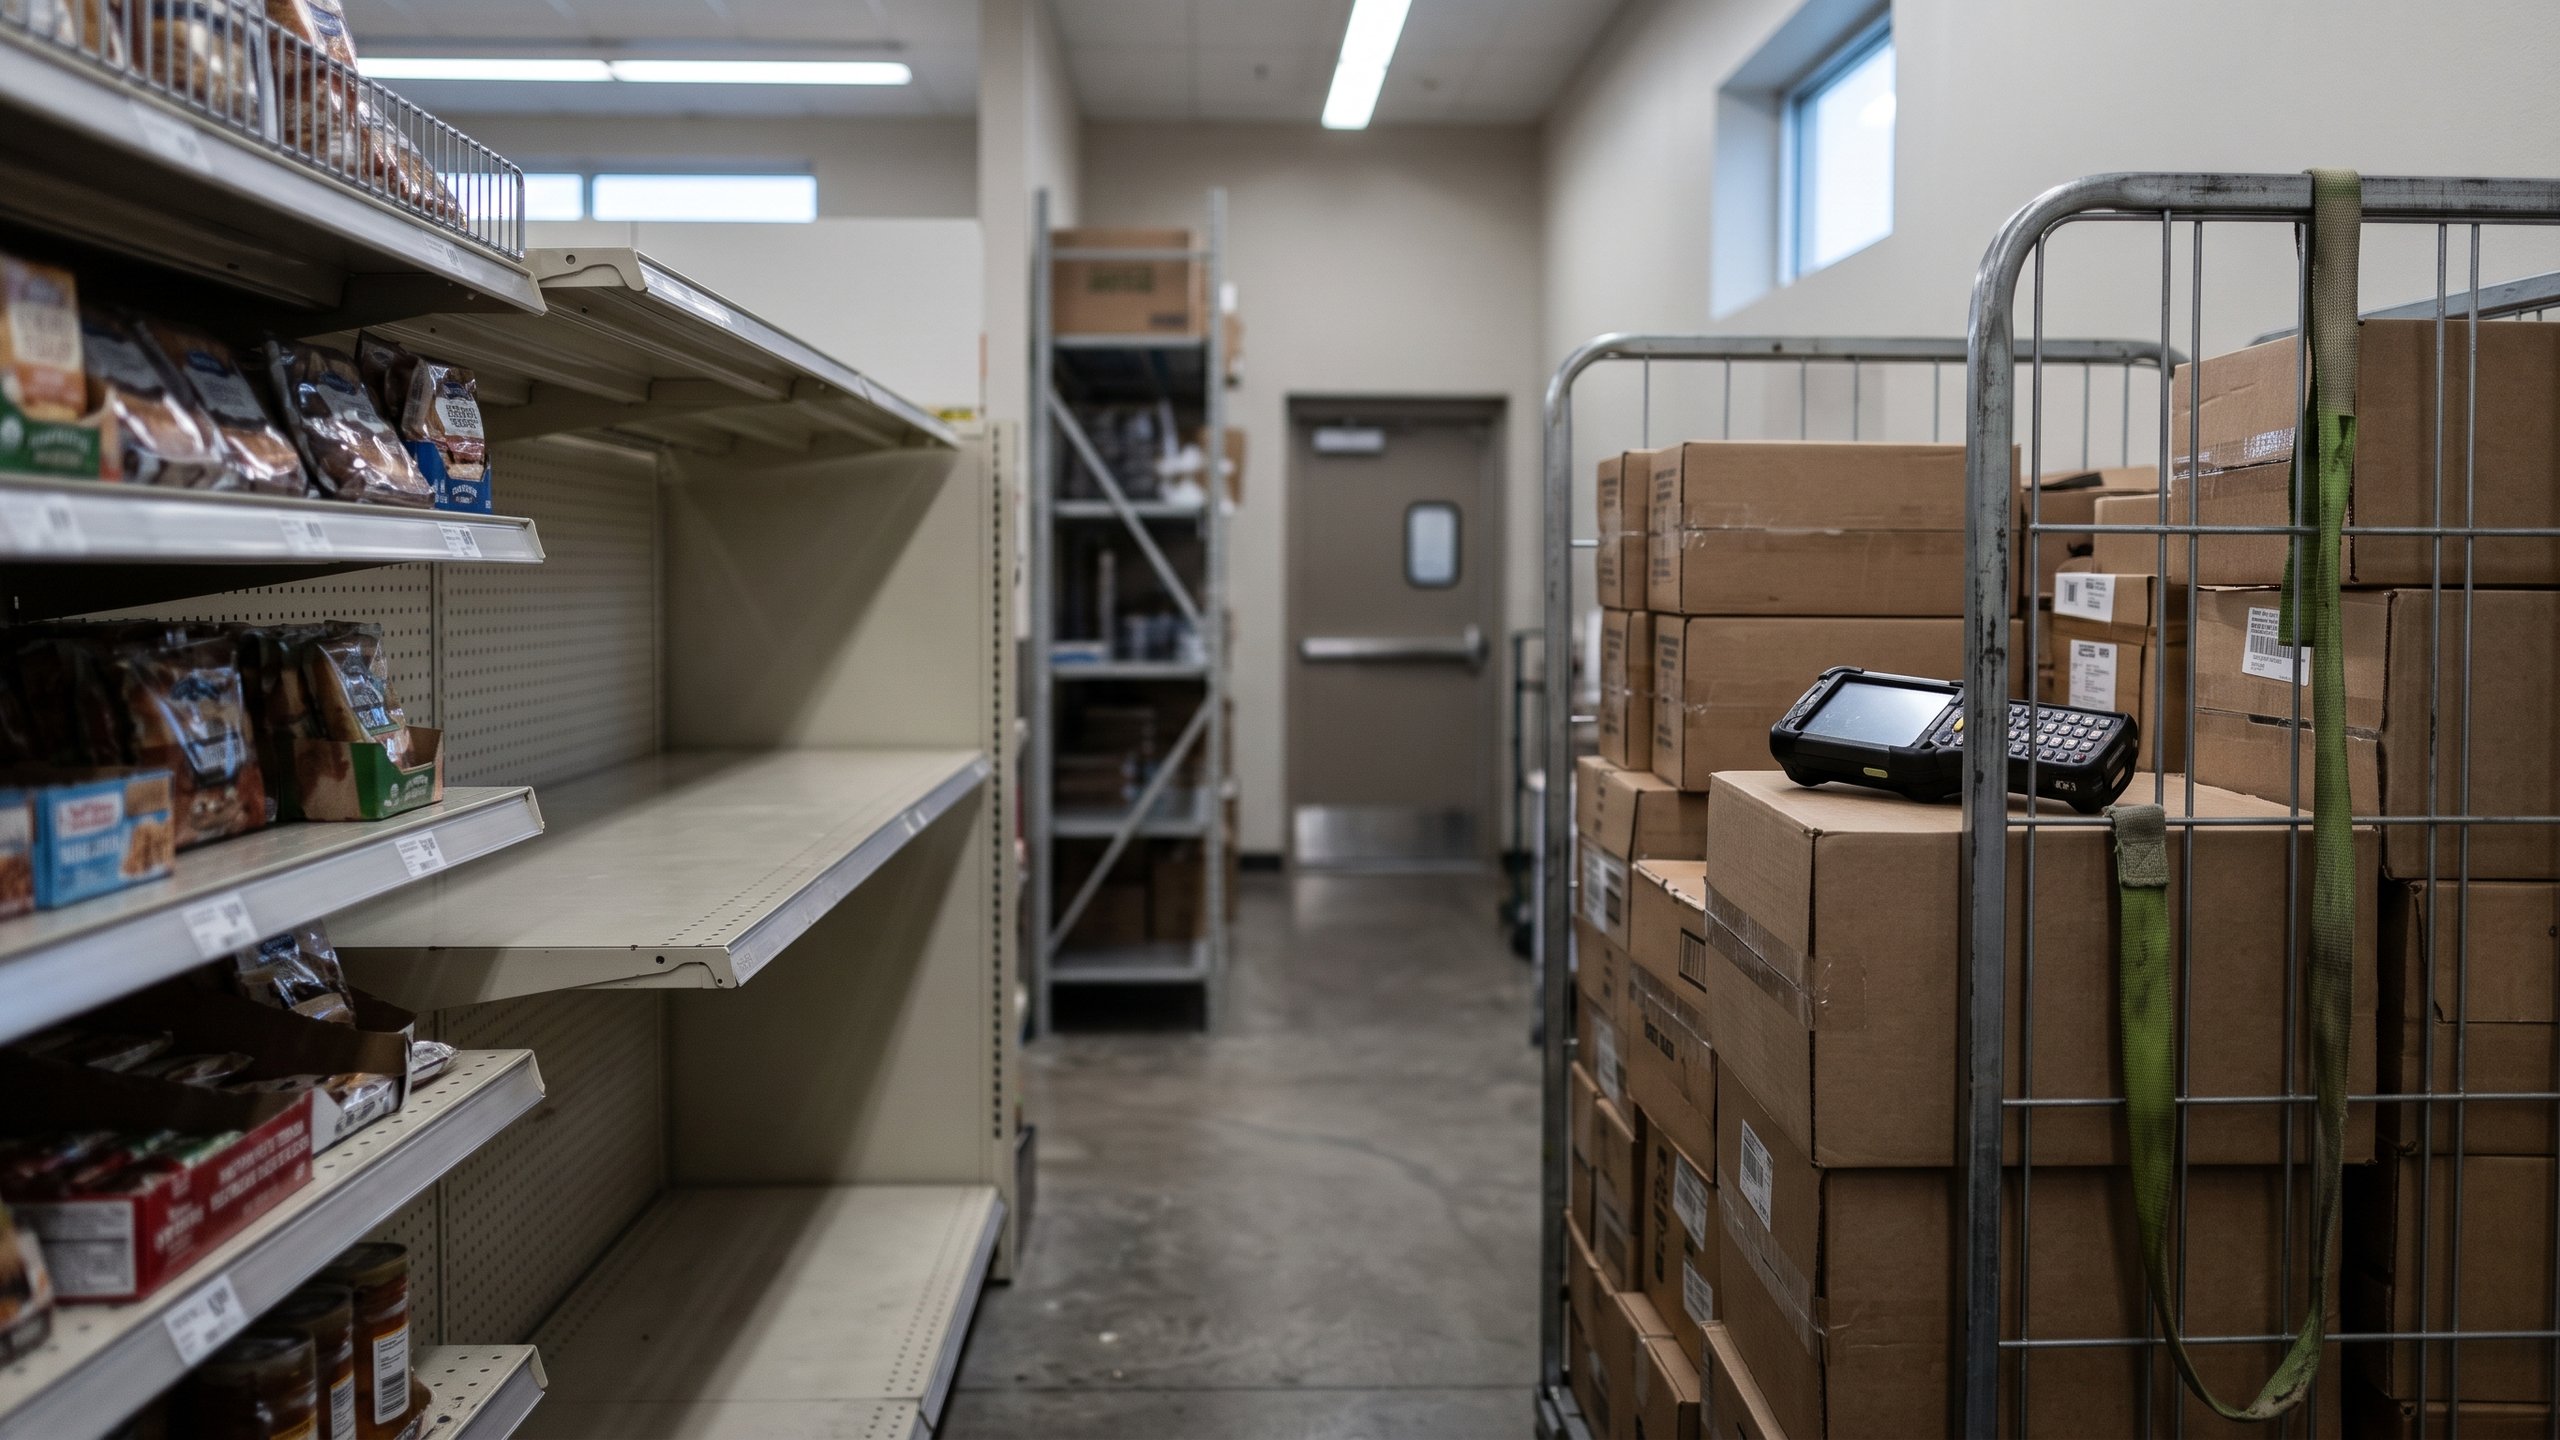
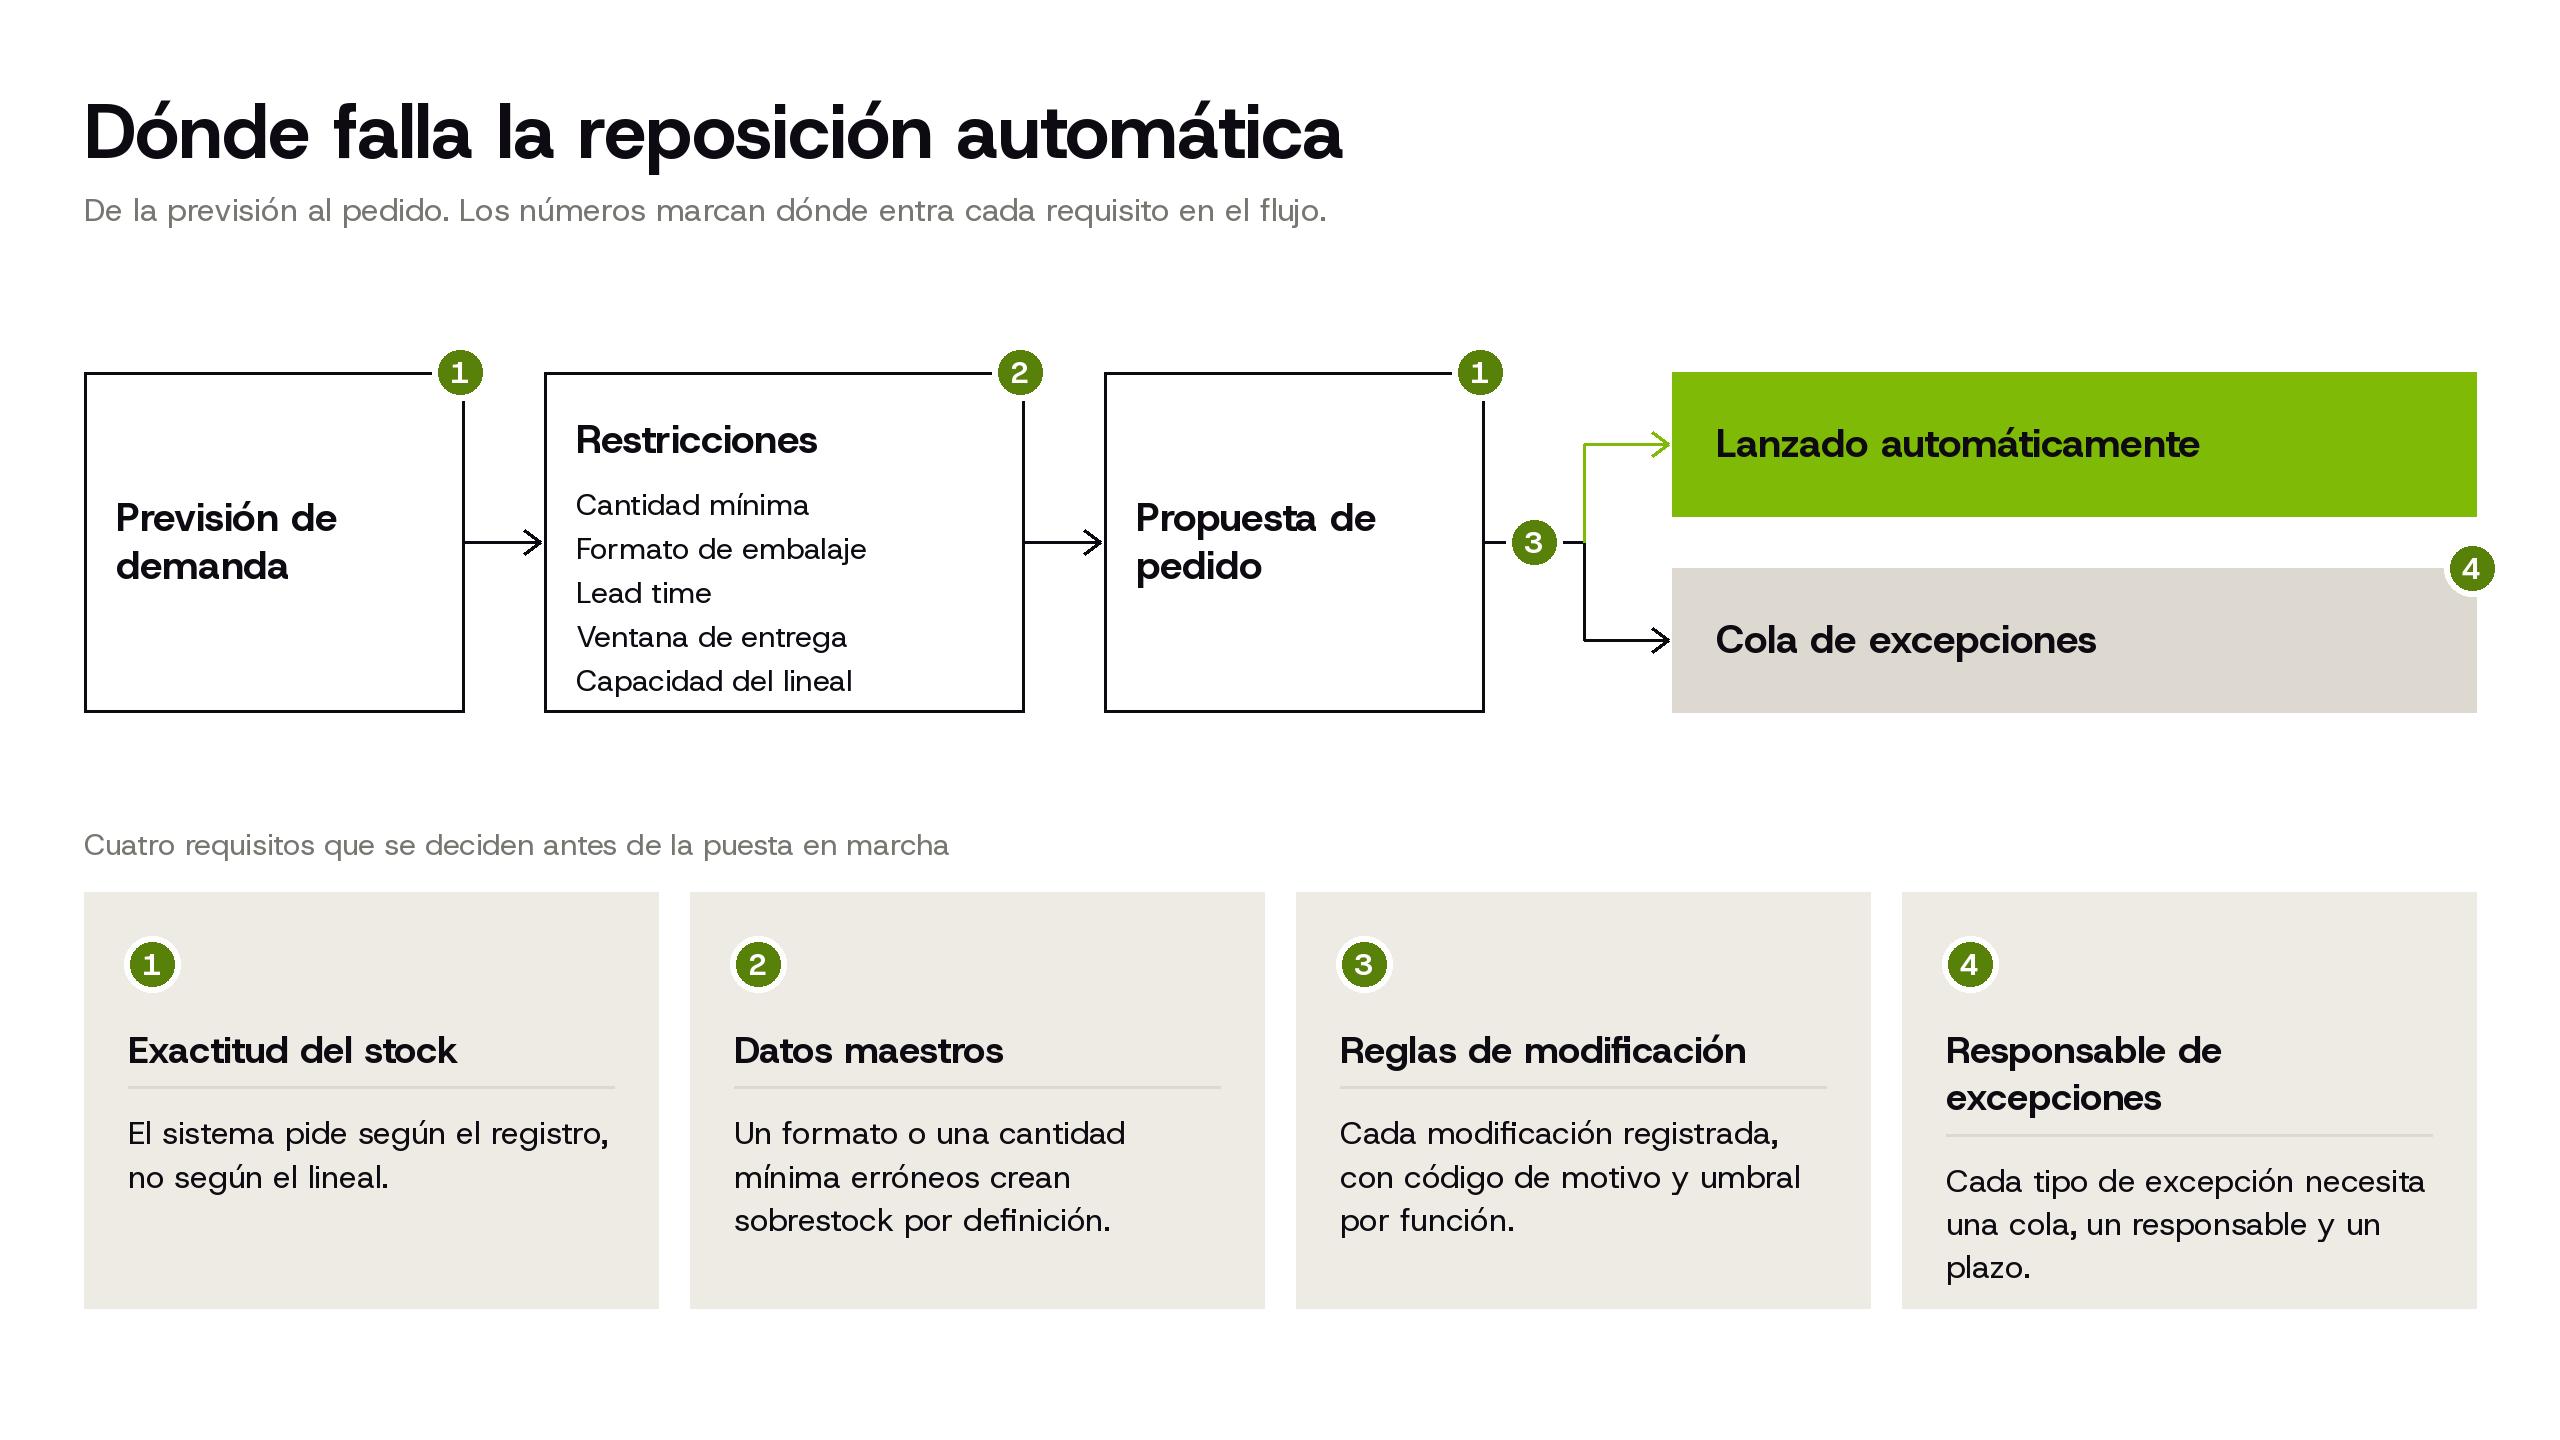
La reposición automática rara vez falla por el algoritmo. Falla en cuatro cosas que se deciden antes de la puesta en marcha: lo exactos que son los registros de stock, si los datos maestros se corresponden con la realidad, quién puede modificar lo que propone el sistema y quién es responsable de las excepciones. Esta es la lista de comprobación que usamos en los proyectos, incluidas las situaciones en las que desaconsejamos automatizar.
¿Qué decide realmente la reposición automática?
Un sistema de reposición automática convierte una previsión de demanda en un pedido concreto para cada referencia y ubicación. Calcula cuánto pedir y cuándo, y respeta las restricciones que hacen ejecutable un pedido: cantidad mínima de pedido, formato de embalaje y palé, lead time del proveedor, ventanas de entrega y el espacio disponible en el lineal o en la ubicación del almacén.
Esa es la diferencia con el punto de pedido que ofrecen la mayoría de los ERP. Un punto de pedido estático lanza un pedido cuando el stock cae por debajo de un nivel fijo. No sabe que la demanda del viernes duplica la del martes, que el proveedor solo entrega los lunes ni que el lineal admite 24 unidades y la caja contiene 36. Así que produce uno de dos resultados, según cómo se fijara el nivel: roturas de stock habituales o una trastienda llena de producto que no cabe en el lineal.
Lo que el sistema no asume es la responsabilidad. Calculará un pedido correcto sobre una cifra de stock errónea, un formato de embalaje equivocado o una modificación del planificador, y lo hará para miles de referencias cada noche. Todo lo que sigue en esta guía trata de los datos y decisiones que siguen en manos de las personas. Si busca el argumento más amplio de por qué una mejor previsión, por sí sola, no eleva la disponibilidad, lo expusimos en un artículo aparte sobre previsión y ejecución. Aquí empezamos un paso después: ha decidido automatizar la reposición de tiendas y quiere saber si la operación está preparada.
¿Qué exactitud tienen realmente sus registros de stock?
La automatización no reduce los errores de los registros de stock. Los amplifica, porque el sistema pide según el registro, no según el lineal.
La medición más conocida de este problema procede de un estudio de casi 370 000 registros de inventario en 37 tiendas de un mismo retailer, publicado por Nicole DeHoratius y Ananth Raman en Management Science en 2008. El 65 % de los registros no coincidía con el stock físico. El hallazgo más útil para quien prepara un despliegue está más adelante en el artículo: el 26,4 % de la varianza en la inexactitud de los registros se daba entre categorías de producto y solo el 2,7 % entre tiendas. Dónde están los errores depende mucho más de qué se cuenta que de qué tienda lo cuenta.
El mecanismo que encarece esto es el stock fantasma. El registro dice que hay cuatro unidades, el lineal está vacío y el sistema no ve motivo para pedir. La rotura de stock no se resuelve sola. Dura hasta que alguien ve el lineal vacío y corrige el registro, lo que en una tienda grande puede llevar semanas para una referencia de rotación lenta. Un planificador que recorre los pasillos a veces lo detecta. Un sistema que trabaja de noche, nunca.
Lo que revisamos antes de la puesta en marcha se deriva directamente del hallazgo sobre las categorías. Auditamos una muestra de registros por categoría, no tienda por tienda, y empezamos por las categorías donde, según nuestra experiencia, se concentran los errores: frescos, artículos con mucha merma desconocida y multipacks que se venden tanto en pack como por unidad. Junto a la auditoría de muestra, dos informes dicen mucho en poco tiempo: la lista de referencias con stock negativo, que siempre es un error de registro, y el calendario real de recuentos cíclicos, comparado con el que figura en el manual de procesos. Este orden de categorías es una regla de trabajo de nuestros proyectos, no un benchmark publicado, pero rara vez nos ha llevado primero al sitio equivocado.
Los datos maestros son el verdadero proyecto
La mayor parte del trabajo en un proyecto de reposición automática no es configurar el modelo. Es dejar bien los datos maestros y mantenerlos así.
Un formato de embalaje erróneo o una cantidad mínima de pedido desactualizada crean sobrestock por definición. El sistema calcula correctamente, redondea al embalaje o a la cantidad mínima que se le dio y el resultado acaba en el almacén. Los campos que deciden si los pedidos son ejecutables son bien conocidos, y en la mayoría de las empresas varios están incompletos: formato de embalaje y configuración del palé, cantidad mínima de pedido, lead time por proveedor y por centro de distribución, ventanas de entrega, capacidad del lineal o frentes del planograma, estado del ciclo de vida de cada referencia (novedad, regular, en descatalogación) y un calendario de festivos y cierres de tienda.
En Albert, que gestiona más de 300 supermercados en la República Checa, la secuencia lo reflejó. El proyecto empezó con una evaluación de la planificación y los pedidos y con la definición de requisitos de datos comunes. El segundo paso fue un modelo de datos e integraciones que dieron a los equipos comerciales y logísticos una única fuente de verdad. Solo después se configuró la previsión de la demanda regular y promocional y se conectó a las reglas de reposición.
La parte fácil de saltarse es la responsabilidad. Una limpieza puntual antes de la puesta en marcha aguanta unos meses. Después se dan de alta referencias nuevas con valores por defecto, un proveedor cambia su formato de palé y nadie actualiza el campo porque nadie es responsable de él. Cada campo que genera un pedido necesita un responsable con nombre y un proceso de cambios, o los datos vuelven discretamente a donde estaban.
¿Quién puede modificar lo que propone el sistema?
Si cualquiera puede cambiar una propuesta de pedido, sin registro y sin umbral, el sistema se convierte en un buzón de sugerencias y la mayor parte de su beneficio desaparece.
La investigación sobre los ajustes de previsión da una idea de lo que está en juego. Robert Fildes, Paul Goodwin y Shari De Baets analizaron unas 147 000 previsiones de seis estudios con un marco común, en un trabajo publicado en el International Journal of Forecasting en 2024. Los ajustes basados en el criterio de los planificadores mejoraron el sesgo y la precisión solo en algo más de la mitad de las referencias. Los ajustes al alza tenían más probabilidades de empeorar la previsión, mientras que los ajustes grandes a la baja solían mejorarla. Las pruebas de que los planificadores usaban información que el algoritmo no tenía eran débiles. Parecían reaccionar a señales irrelevantes o de escaso valor diagnóstico.
El mismo patrón se aplica a los pedidos, con un coste añadido. Cuando un planificador redondea un pedido al alza «por si acaso», la modificación se salta además las restricciones que el sistema respetaba: la capacidad del lineal, la ventana de entrega, el formato de embalaje. El stock adicional no se queda solo en el cálculo. Se queda en la trastienda.
Esto no significa que haya que prohibir las modificaciones. Significa que necesitan reglas. En la práctica funcionan tres cosas: un registro de cada modificación con un código de motivo, umbrales por función (un jefe de tienda puede ajustar dentro de una banda; los cambios mayores pasan al equipo central) y una revisión periódica de si las modificaciones aportaron valor, con la misma lógica de forecast value added aplicada a los pedidos en lugar de a las previsiones. La distinción útil es entre dos tipos de modificación. «Sé algo que el sistema no sabe» es legítimo: una referencia nueva sin histórico, un problema de suministro conocido, un evento local. «No me fío de la cifra» es una señal para corregir el dato de entrada, no para cambiar el resultado.
Alguien tiene que ser responsable de las excepciones
El objetivo de la automatización no es que nadie toque nada. Es que se toque poco, en los sitios adecuados y por alguien cuyo trabajo sea ese.
Una excepción es cualquier pedido que el sistema no puede o no debe lanzar por sí solo: un pedido bloqueado por un límite de capacidad, un proveedor que no entregó, una promoción que coincide con un pico estacional, una referencia nueva sin histórico, una tienda que ha llegado a su techo de almacenamiento. Cada tipo necesita una cola, un responsable y un plazo. Sin eso, las excepciones se acumulan en una bandeja que nadie abre y los planificadores vuelven a montar los pedidos a mano porque les parece más seguro.
En Košík.cz, el supermercado online, la disponibilidad de producto llegó al 97 % y las mermas bajaron un 75 % tras la puesta en marcha de Veritico STOCK junto con el rediseño de los procesos de pedido y de almacén. Tomáš Jeřábek, CEO de la empresa, describe así el efecto: al cabo de unas semanas, el valor medio diario de las mermas por caducidad bajó a una cuarta parte. El caso de éxito también recoge menos trabajo manual en los pedidos. Ese trabajo no desapareció. Pasó de montar pedidos a gestionar las referencias que realmente necesitaban una decisión.
La cifra que merece la pena seguir desde la primera semana es el touch rate: la parte de las propuestas de pedido que una persona abre antes de lanzarlas. Un touch rate alto que no baja después del primer mes suele indicar que falta alguno de los requisitos anteriores, casi siempre la confianza en los registros de stock.
¿Cómo es un despliegue sensato?
Un despliegue sensato empieza con un piloto sobre una parte del surtido y un grupo de ubicaciones, convive durante un tiempo con el proceso existente y termina con criterios de aceptación acordados antes de empezar.
El proyecto de Albert siguió cuatro fases que recomendaríamos a la mayoría de retailers y distribuidores: evaluar la planificación actual y definir los requisitos de datos, diseñar el modelo de datos y las integraciones, configurar la previsión y las reglas de reposición, y operar y consolidar el sistema durante periodos de volatilidad antes de ampliarlo. La última fase es la que se recorta cuando el presupuesto aprieta, y es la que dice si el sistema aguanta.
La estacionalidad decide cuánto tiene que durar un piloto. Pompo, un retailer checo de juguetes con más de 100 tiendas, negocio mayorista y tienda online, mejoró la disponibilidad de producto un 3 % en un surtido muy estacional en el que la Navidad domina el año. Un piloto que termina en octubre no diría casi nada sobre cómo maneja el sistema las semanas que más importan. Los criterios de aceptación deben redactarse para el periodo en el que el negocio realmente gana o pierde su año.
En las empresas medianas de Chequia y Eslovaquia, lo que frena un piloto rara vez es el proveedor. Es la capacidad del lado del cliente. Dos decisiones marcan la diferencia: una persona dedicada a los datos maestros durante todo el piloto, no prestada por otro equipo unas horas a la semana, y una política de modificaciones acordada antes de lanzar el primer pedido. Sin ellas, el piloto funciona, pero al final nadie puede decir si los resultados vinieron del sistema o de los planificadores que lo esquivaban. Lo mismo se aplica al flujo anterior: si el centro de distribución pide a los proveedores a mano mientras las tiendas están automatizadas, las mejoras se quedan en la puerta del centro, y por eso la reposición de almacenes y los pedidos a proveedores suelen formar parte del mismo plan, aunque se pongan en marcha más tarde.
Cuándo no automatizar la reposición
Hay cuatro situaciones en las que desaconsejamos automatizar, incluso cuando el cliente quiere hacerlo.
- Menos de un ciclo estacional completo de histórico en buena parte del surtido. Nuestro umbral es al menos un ciclo estacional completo, lo que en la práctica significa 12 meses. Por debajo, el modelo no puede separar la estacionalidad de la tendencia y cada pico parece crecimiento. Es nuestra regla de trabajo, no un estándar externo. Un negocio nuevo o un surtido completamente renovado suele necesitar otro enfoque hasta que exista el histórico.
- Un surtido que rota tan deprisa que el modelo no tiene de qué aprender. Los surtidos de tipo moda, en los que la mayoría de las referencias vive una temporada, necesitan previsión basada en atributos y asignación, no reposición clásica.
- Nadie responsable de los datos maestros. Sin esa persona, la automatización vuelve al modo manual en pocos meses y la empresa acaba pagando un sistema que sus planificadores esquivan.
- Un cambio de ERP o WMS en los próximos doce meses. Primero la capa de sistemas y después la reposición. El orden inverso obliga a construir las integraciones dos veces y a hacer el piloto con datos que están a punto de cambiar. Describimos lo que se rompe en la planificación durante un cambio así en nuestra guía sobre la puesta en marcha de ERP y WMS.
Hay un límite más que afecta a una parte del surtido y no a todo el proyecto. Para las referencias con demanda intermitente muy marcada, como los repuestos o la cola larga de un surtido de ferretería, una regla mín./máx. sencilla con revisión humana periódica suele ser más barata y más estable que la automatización completa. Automatizarlo todo no es el objetivo. El objetivo es automatizar las referencias en las que el sistema decide mejor que una persona.
Cuatro cifras que medir antes de firmar nada
Cuatro cifras dicen más sobre las posibilidades de un proyecto que cualquier comparación de funcionalidades de proveedores:
- La exactitud de los registros de stock por categoría, a partir de una auditoría de muestra, con las tres peores categorías identificadas.
- La completitud de los datos maestros que generan pedidos, como porcentaje de referencias activas con todos los campos de la lista anterior rellenos y verificados.
- La parte de los pedidos que hoy se modifica a mano, y en qué dirección.
- El volumen semanal de excepciones que ya gestiona el proceso actual, las llame alguien así o no.
Si las dos primeras son débiles, corríjalas antes de que empiece el piloto. Si la tercera es alta, acuerde la política de modificaciones antes de la puesta en marcha. Si nadie puede dar la cuarta, la cola de excepciones todavía no tiene responsable. Una vez conocidas estas cuatro cifras, probar una herramienta con sus propios datos tiene sentido, y explicamos cómo hacerlo en nuestra guía para elegir y probar software de optimización de inventario.
Preguntas frecuentes
Al menos un ciclo estacional completo, que para la mayoría de retailers y distribuidores significa 12 meses. Con menos, el modelo no distingue los picos estacionales del crecimiento. Las referencias con menos histórico se pueden incluir, pero necesitan reglas para novedades y una revisión más cercana hasta que se acumule el histórico.
En la reposición de tiendas, sí, siempre que los registros de stock de las tiendas sean fiables y el proveedor o el centro de distribución pueda ejecutar los pedidos. En la reposición de almacenes y centros de distribución, el sistema necesita datos exactos de stock y ubicaciones, que en la práctica suelen venir de un WMS. Sin él, la exactitud del registro del almacén es lo primero que hay que resolver.
Un sistema de reposición necesita como dato de entrada una previsión promocional, no solo la baseline. Cuando las promociones se planifican en una hoja de cálculo aparte, el sistema de reposición ve el incremento solo cuando empiezan las ventas. Conectar la planificación de promociones con la reposición es lo que permite que el stock llegue antes de la promoción y no durante ella.
Sí, pero harán otro trabajo. En lugar de montar pedidos referencia por referencia, gestionan excepciones, mantienen las reglas y los datos que hay detrás y deciden los casos en los que saben algo que el sistema no sabe. Los equipos que planifican este cambio conservan a sus mejores planificadores. Los que no lo hacen suelen ver cómo esos planificadores modifican el sistema para seguir siendo útiles.
De nuestros proyectos
Reposición automatizada para MILK‑AGRO
MILK‑AGRO automatizó la reposición de tiendas con Veritico Stock, aumentó la disponibilidad en las estanterías por encima del 98 por ciento y estabilizó el inventario con menos esfuerzo manual.
Nivel de servicio del 98%+ en tiendas.
Mejora la rotación del inventario.
Menores pérdidas por vencimiento y revaluación.
Optimización de inventario para GGT
La previsión y reposición automatizadas en más de 800 sucursales generaron mayores ventas, un stock más reducido y pedidos más rápidos.
+5 % facturación
–15 % de existencias
–60 % tiempo para crear pedidos
Más conocimientos sobre supply chain
Glosario de supply chain
Cross‑docking
Qué es el cross‑docking, en qué se diferencian sus variantes preasignada y posasignada y por qué traslada el stock de seguridad a las tiendas.
19. november 2026
3 min
Whitepapers e informes
Inventario gestionado por el proveedor (VMI): cuándo compensa ceder la reposición y cuándo sale caro
El VMI traslada el pedido al proveedor, pero por sí solo no saca stock de la cadena. Cuándo compensa a un minorista, cuándo sale caro y qué acordar antes de firmar.
19. november 2026
11 min
Glosario de supply chain
Slotting
Qué es el slotting, por qué las referencias se ordenan por líneas de picking y no por unidades vendidas y cómo el tamaño de la ubicación fija las reposiciones.
18. november 2026
3 min